

Pour un échange ponctuel de quelques milliers de lignes, le CSV fait l'affaire. Pour l'analytique, il coûte cher : chaque requête relit et redécode l'intégralité du fichier, sans schéma ni compression. Parquet a été conçu pour l'inverse : stocker par colonnes, compresser, et ne lire que ce dont la requête a besoin.
Cet article reprend les six visuels de notre présentation et explique ce que chacun montre.
1. Même requête, 1,15 To lus contre 2,51 Go
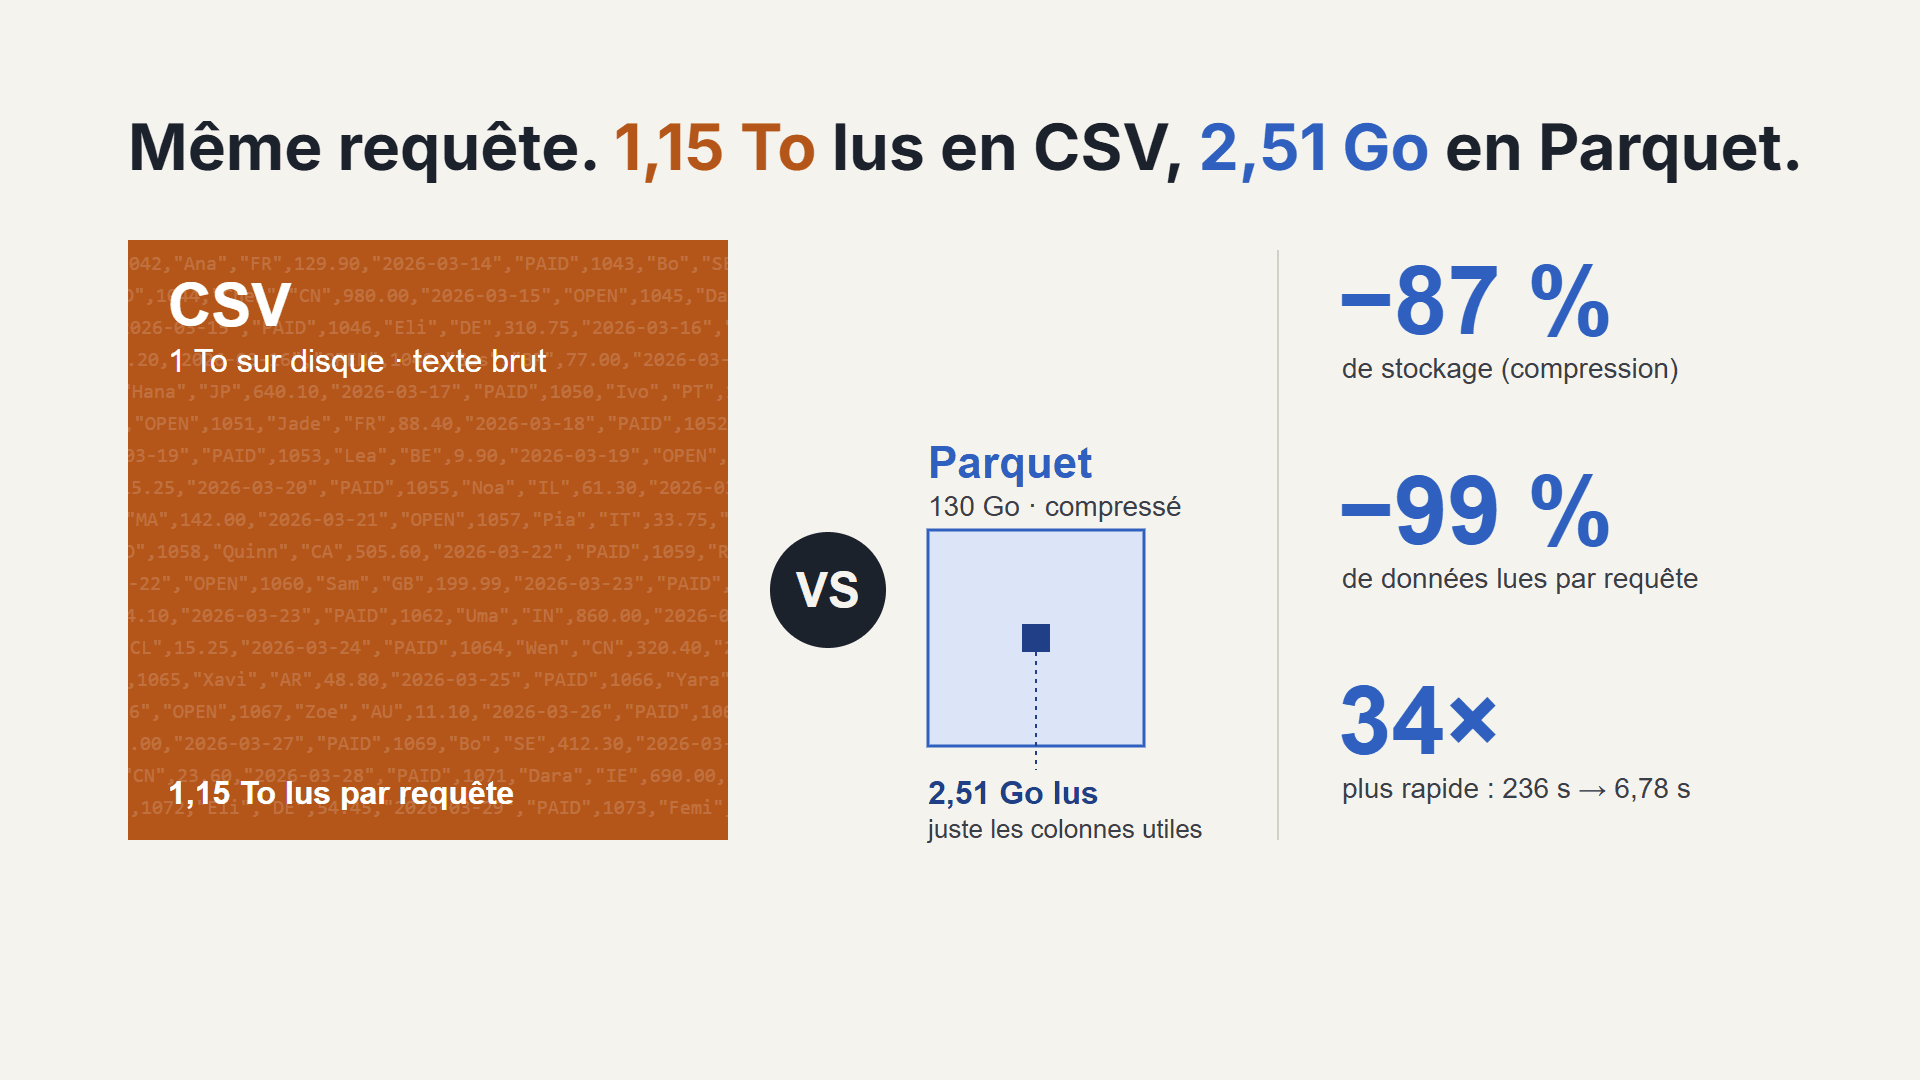
Les carrés du visuel sont à l'échelle : leur surface correspond au volume de données. Les chiffres viennent d'un exemple publié par Databricks, sur un jeu de données de 1 To interrogé avec Amazon Athena.
| Mesure | CSV | Parquet | Écart |
|---|---|---|---|
| Taille sur disque | 1 To | 130 Go | −87 % |
| Données lues par la requête | 1,15 To | 2,51 Go | −99 % |
| Durée de la requête | 236 s | 6,78 s | 34× plus rapide |
| Coût de la requête | 5,75 $ | 0,01 $ | −99,7 % |
Deux mécanismes expliquent l'écart. La compression par colonne réduit la taille sur disque : des valeurs de même type, stockées côte à côte, se compressent bien mieux qu'un texte où tout est mélangé. Ensuite, le moteur ne lit que les colonnes utiles à la requête et saute les blocs que les statistiques excluent. Sur un service facturé au volume lu, comme Athena, le coût suit directement.
Source : Databricks, « What is Parquet? »
2. Row groups et statistiques min/max
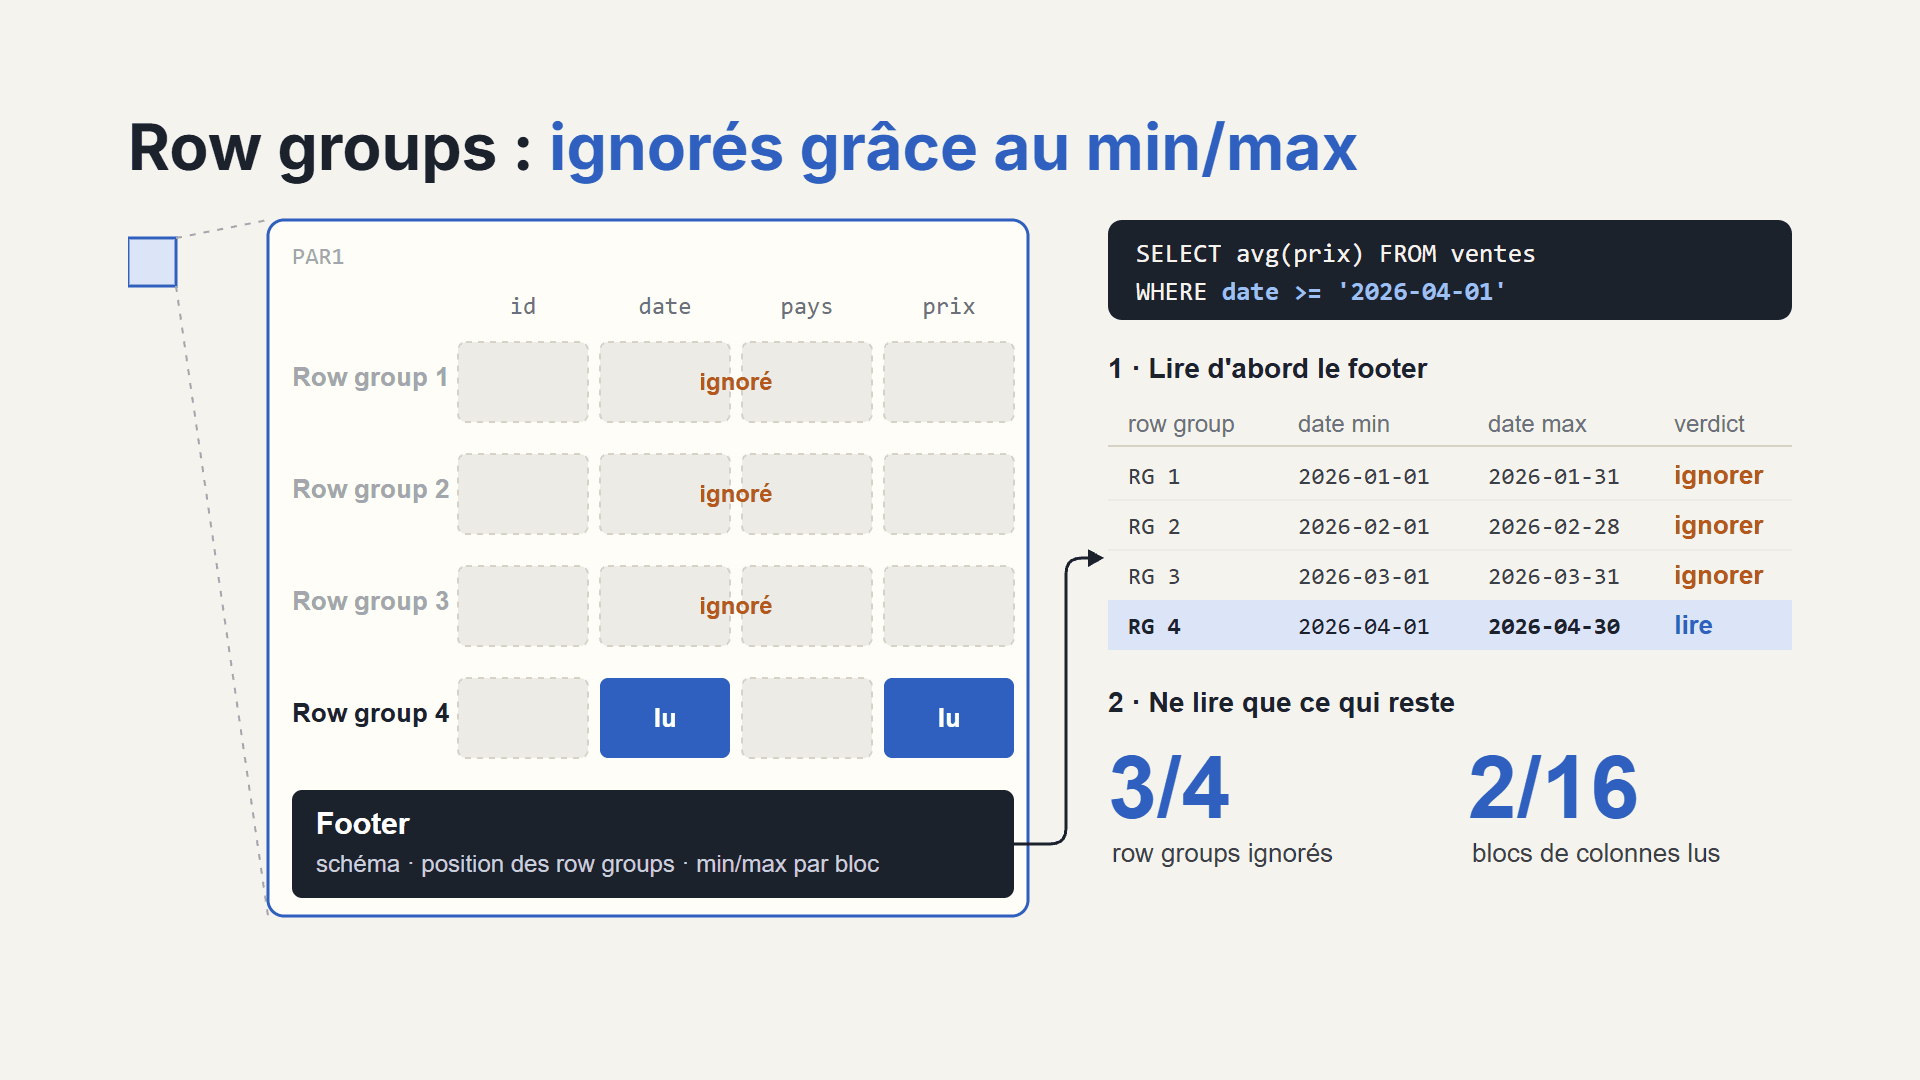
Un fichier Parquet est découpé horizontalement en row groups, puis chaque row group verticalement en blocs de colonnes. À la fin du fichier, le footer décrit le schéma, la position de chaque row group et, pour chaque bloc, la valeur minimale et maximale qu'il contient.
Le moteur lit ce footer avant toute donnée. Prenons la requête SELECT avg(prix) FROM ventes WHERE date >= '2026-04-01' sur un fichier de quatre row groups, un par mois :
- Les row groups 1 à 3 ont une date maximale antérieure au 1er avril. Ils ne peuvent contenir aucune ligne utile et sont ignorés sans être lus.
- Dans le row group 4, seuls les blocs
dateetprixsont nécessaires. Les blocsidetpaysne sont pas lus.
Résultat : 2 blocs de colonnes lus sur 16. Deux élagages se combinent, par les statistiques pour les lignes et par la requête pour les colonnes.
L'efficacité dépend de l'ordre des données. Si les dates sont réparties au hasard dans le fichier, chaque row group couvre toute la plage et aucun ne peut être ignoré. Trier ou regrouper les données sur les colonnes filtrées avant l'écriture est donc déterminant.
3. Partitionnement Hive
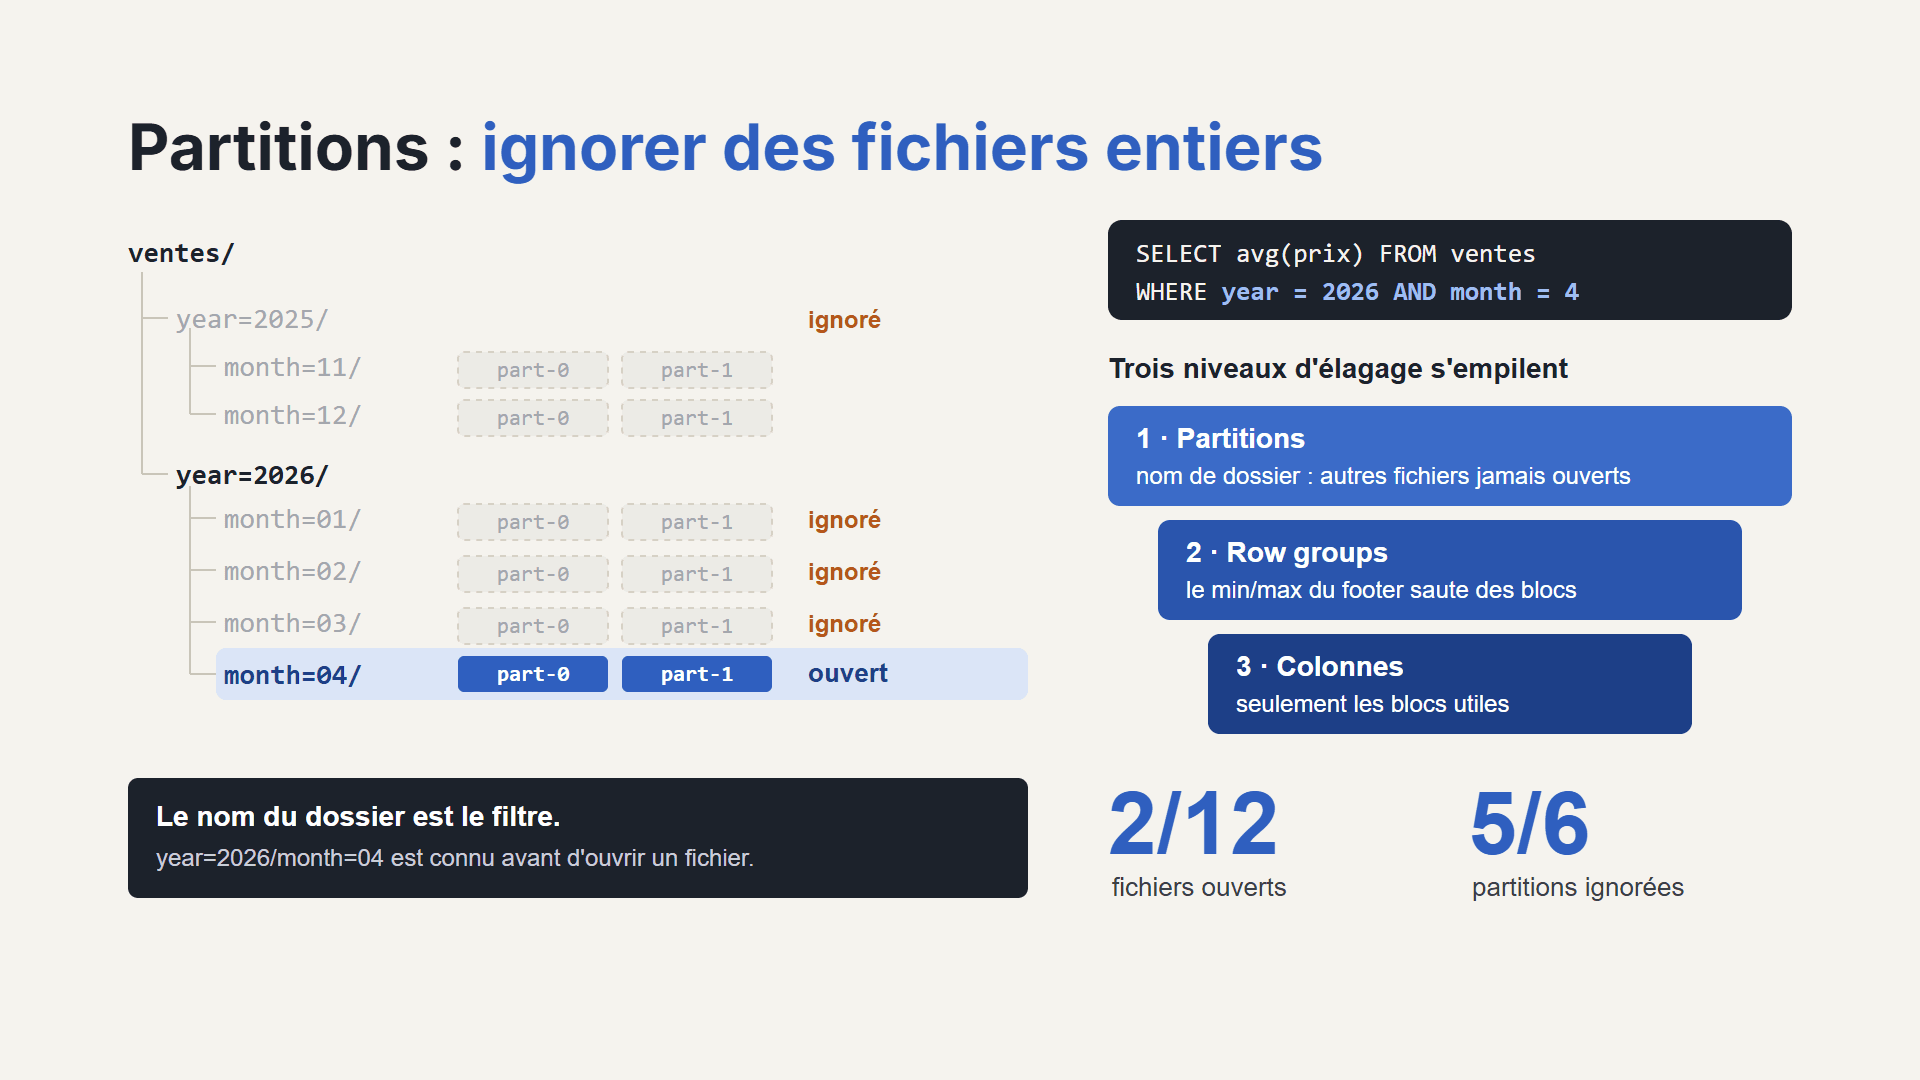
Un jeu de données réel tient rarement en un seul fichier. Avec le partitionnement de type Hive, il prend la forme d'une arborescence où chaque nom de dossier porte une valeur : ventes/year=2026/month=04/part-0.parquet.
Pour la requête WHERE year = 2026 AND month = 4, le moteur liste les dossiers et ne garde que celui qui correspond. Les autres partitions sont écartées d'après leur seul nom, sans ouvrir un fichier. Dans l'exemple de la présentation, 2 fichiers sur 12 sont ouverts et 5 partitions sur 6 sont ignorées.
Trois niveaux d'élagage s'empilent ainsi avant toute lecture de données :
- Les partitions, par nom de dossier.
- Les row groups, par les statistiques min/max du footer.
- Les colonnes, par la requête.
Le choix de la clé de partitionnement compte. Elle doit correspondre aux filtres fréquents et rester de cardinalité modérée : année et mois conviennent, un identifiant client produirait des milliers de petits fichiers, coûteux à lister et à ouvrir.
4. Un format ouvert, lisible partout
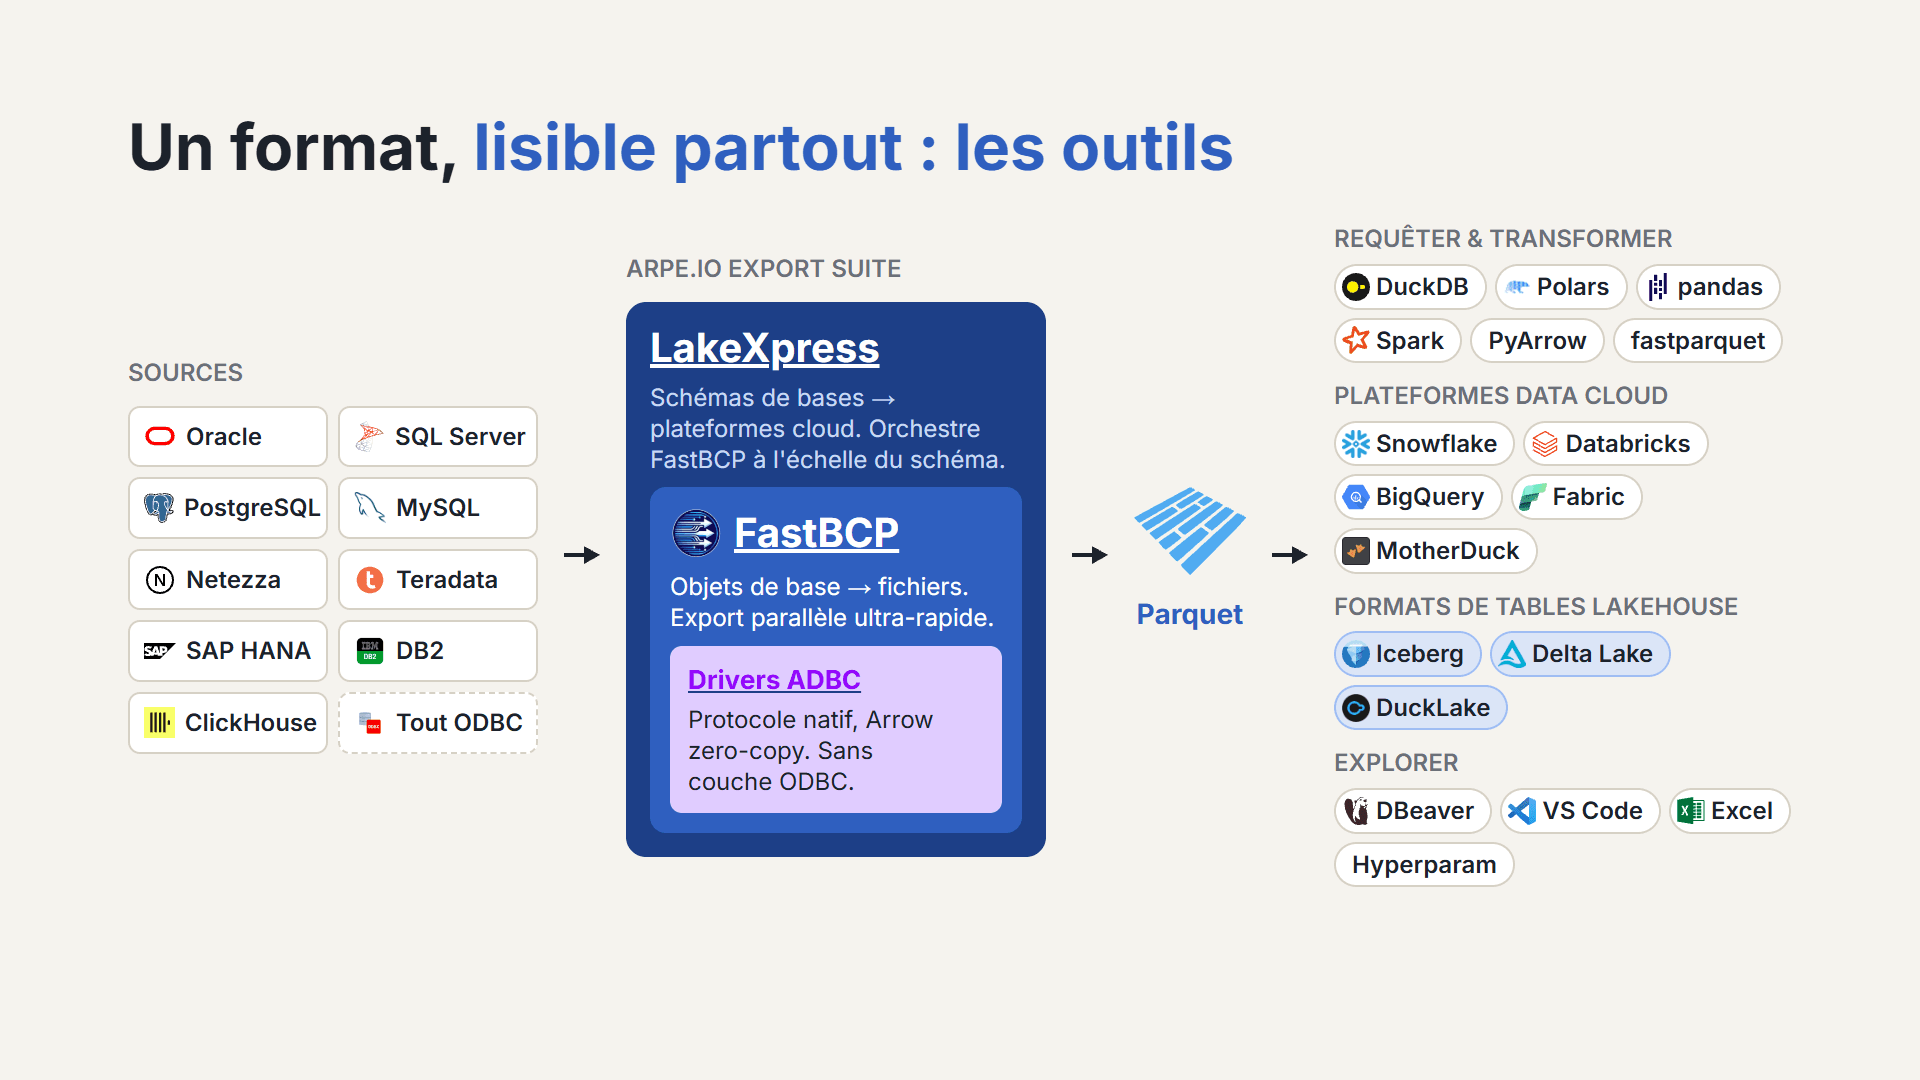
Parquet est un format ouvert de la fondation Apache. Un fichier écrit une fois peut être lu par la plupart des outils de données actuels, sans conversion.
Produire du Parquet depuis les bases de données. Les données sources résident le plus souvent dans des bases relationnelles : Oracle, SQL Server, PostgreSQL, MySQL, Netezza, Teradata, SAP HANA, DB2, ClickHouse, ou toute base accessible en ODBC. La suite d'export ARPE.IO s'organise en trois couches imbriquées :
- Les drivers ADBC parlent le protocole natif de chaque base et produisent directement des données au format Apache Arrow, sans copie, sans couche ODBC ni bibliothèque cliente de l'éditeur.
- FastBCP embarque ces drivers et exporte tables et requêtes vers des fichiers, en parallèle.
- LakeXpress orchestre FastBCP pour exporter des schémas entiers en Parquet vers les plateformes cloud.
Lire et exploiter le Parquet.
| Usage | Outils |
|---|---|
| Requêter et transformer | DuckDB, Polars, pandas, Apache Spark, PyArrow, fastparquet |
| Plateformes data cloud | Snowflake, Databricks, BigQuery, Microsoft Fabric, MotherDuck |
| Formats de tables lakehouse | Apache Iceberg, Delta Lake, DuckLake |
| Explorer | DBeaver, VS Code, Excel, Hyperparam |
Les formats de tables lakehouse stockent leurs données en fichiers Parquet et ajoutent par-dessus une couche de métadonnées. C'est elle qui apporte les transactions, l'historique des versions et l'évolution fiable du schéma, puisqu'un fichier Parquet est immuable une fois écrit.
5. Synthèse
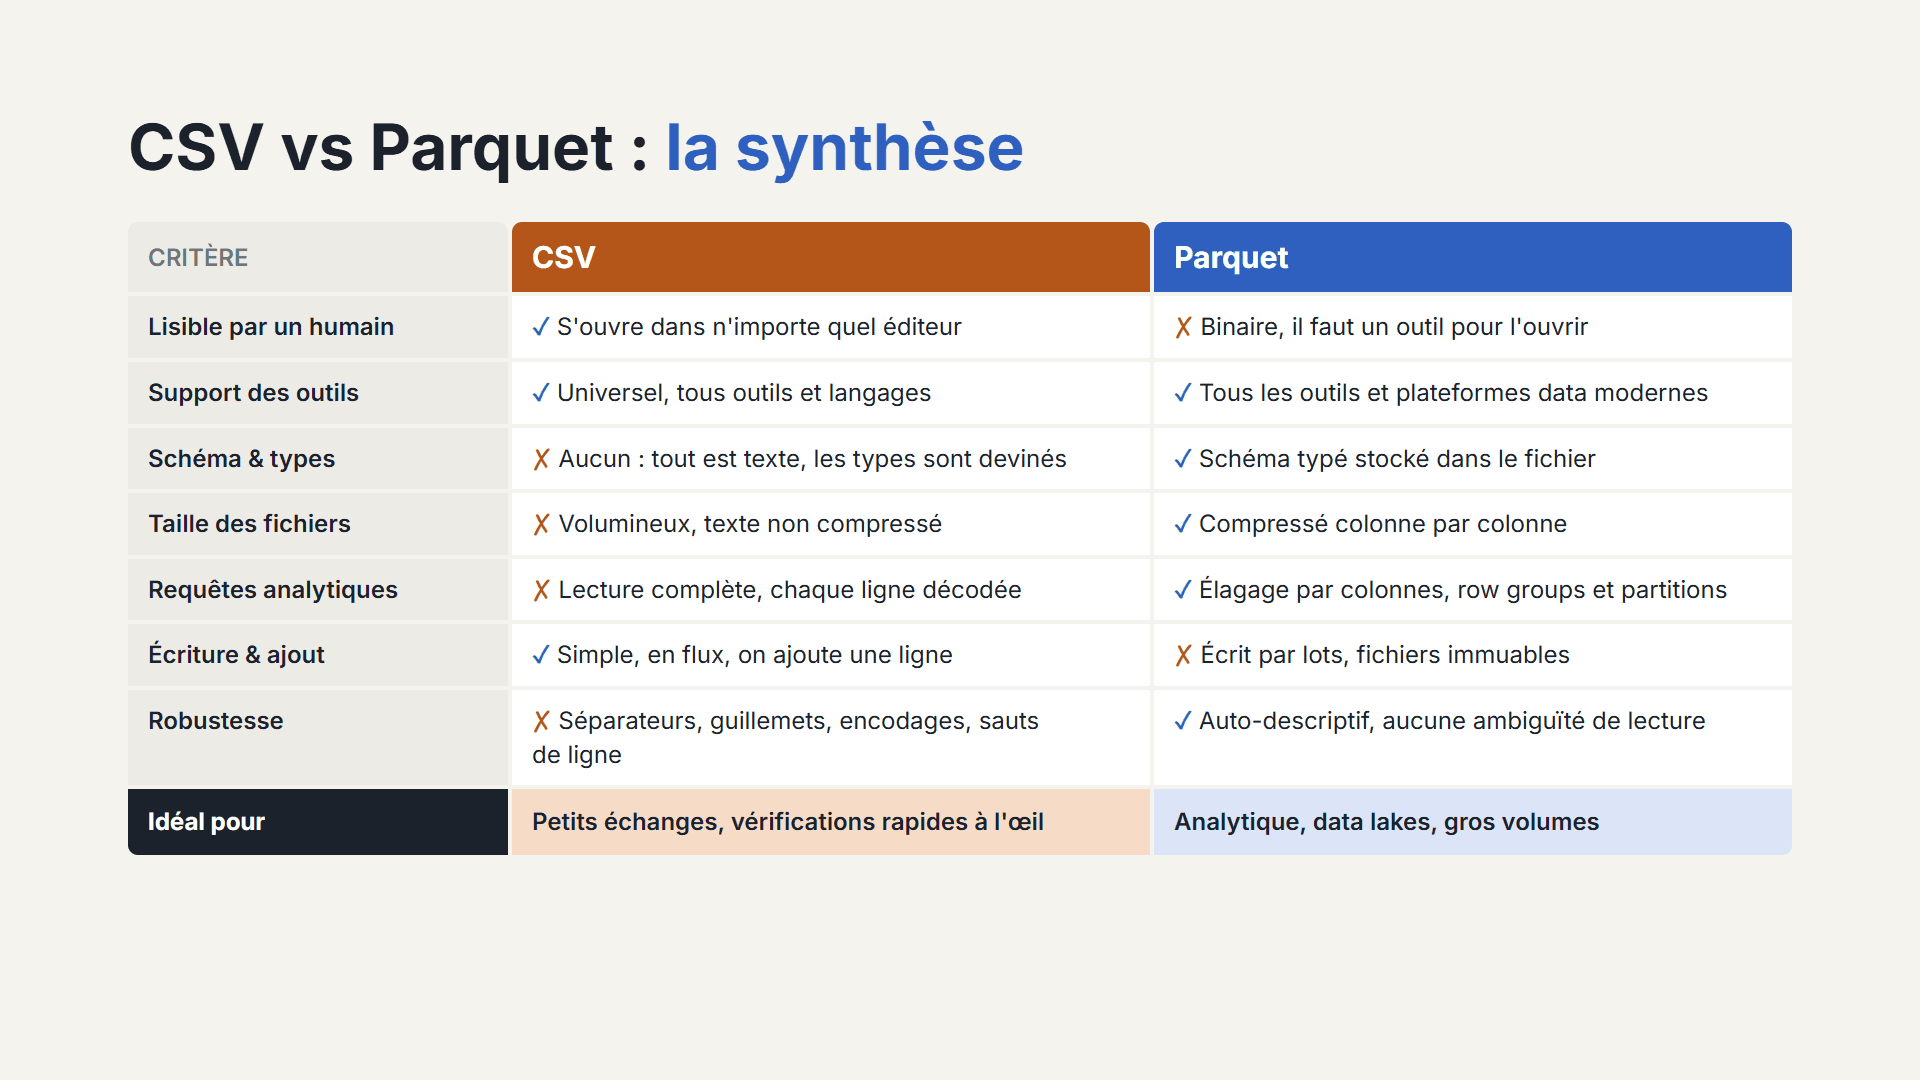
Le CSV garde deux atouts réels : n'importe qui peut l'ouvrir, et il s'écrit ligne par ligne. Pour tout le reste, Parquet l'emporte.
| Critère | CSV | Parquet |
|---|---|---|
| Lisibilité humaine | Oui, dans un éditeur de texte | Non, outil nécessaire |
| Support des outils | Universel | Outils et plateformes data modernes |
| Schéma et types | Aucun, types devinés à la lecture | Schéma typé stocké dans le fichier |
| Taille des fichiers | Volumineux, non compressé | Compressé colonne par colonne |
| Requêtes analytiques | Lecture complète de chaque ligne | Élagage par colonnes, row groups et partitions |
| Écriture et ajout | En flux, ajout ligne par ligne | Par lots, fichiers immuables |
| Robustesse | Sensible aux séparateurs, guillemets, encodages | Auto-descriptif, sans ambiguïté |
| Usages typiques | Petits échanges, vérifications manuelles | Analytique, data lakes, gros volumes |
En pratique : gardez le CSV pour les petits échanges et les contrôles à l'œil, et passez à Parquet dès que les données sont volumineuses ou interrogées régulièrement.


